Módulo 5: Especialización Analítica
En las etapas previas del pipeline, hemos visto cómo mover datos y transformarlos utilizando herramientas generalistas. Sin embargo, cuando el volumen de datos crece y las consultas se vuelven complejas (agregaciones, joins masivos, ventanas temporales), chocamos con el cuello de botella de la Compute Efficiency (Eficiencia de Cómputo).
Las herramientas de procesamiento generalista a menudo sufren una degradación de rendimiento debido a la serialización de datos, la gestión ineficiente de la memoria o la falta de optimizaciones específicas para cargas de trabajo OLAP (Online Analytical Processing). Para superar esto, necesitamos motores de cómputo especializados que puedan operar directamente sobre los datos sin moverlos.
El Cuello de Botella: Compute Efficiency
El problema fundamental en el análisis de datos a gran escala no es solo el almacenamiento, sino cómo el CPU accede a esos datos. Los enfoques tradicionales suelen requerir:
1. Copias innecesarias: Mover datos entre el disco, la memoria y el motor de ejecución.
2. Sobrecarga de Tipado: Convertir formatos binarios en objetos de lenguaje de alto nivel (como objetos Python), lo que consume ciclos de CPU y dispara el uso de memoria.
3. Lecturas Ineficientes: Leer columnas que no se necesitan para la consulta (falta de proyección vertical).
Para resolver esto, combinamos dos tecnologías clave: Apache Arrow para el transporte y almacenamiento en memoria, y DuckDB como el motor de ejecución especializado.
Enfoque en Apache Arrow: Polyglot Compute
Apache Arrow no es una base de datos, sino un formato de memoria columnar estandarizado. Su gran ventaja es el Zero-Copy IO: permite que diferentes herramientas (Python, R, Java, C++, DuckDB) compartan los mismos buffers de memoria sin necesidad de serializar o deserializar los datos.
Esto habilita el concepto de Polyglot Compute: la capacidad de usar la mejor herramienta para cada paso del pipeline sin pagar el "impuesto" de transferencia de datos.
En este ecosistema, DuckDB actúa como el motor de SQL especializado que "se monta" sobre los datos gestionados por Arrow. DuckDB no necesita importar los datos en su propio formato interno; puede ejecutar consultas SQL complejas directamente sobre las tablas de Arrow, aprovechando la eficiencia del formato columnar y la velocidad de un motor vectorizado.
Caso de Uso: NYC Taxi Dataset
Analizaremos el TLC Trip Record Data, un conjunto de datos masivo ideal para demostrar la eficiencia de un motor especializado frente a uno generalista.
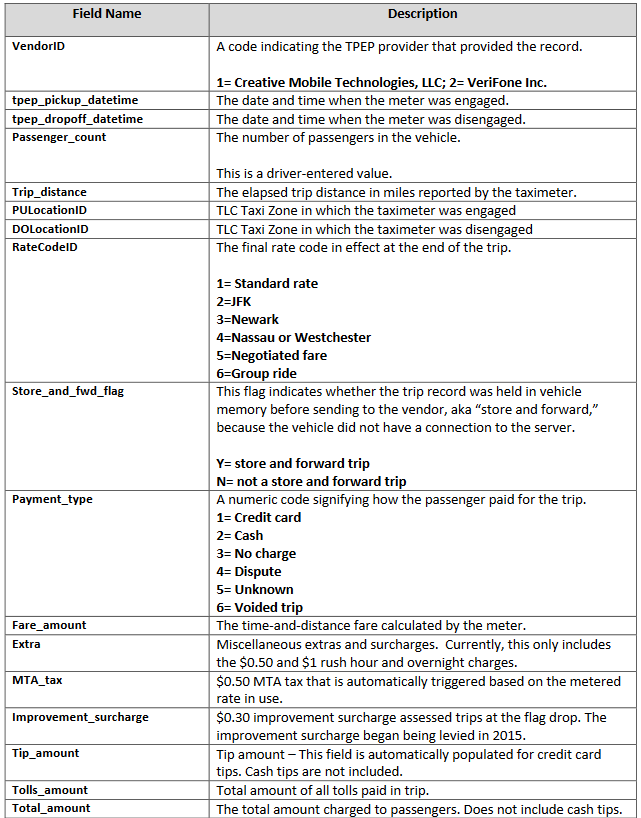
1. Scan Parquet como tabla Arrow
Primero, utilizamos PyArrow para crear una vista sobre los datos particionados en disco. Gracias a la Lazy Evaluation, no cargamos todo el dataset en memoria, sino que definimos un scanner que solo traerá los datos necesarios.
import duckdb
import pyarrow as pa
import pyarrow.dataset as ds

# Definimos las columnas relevantes para evitar leer datos innecesarios (Proyección Vertical)
working_columns = ["VendorID","tpep_pickup_datetime","tpep_dropoff_datetime","passenger_count",
                   "trip_distance","RatecodeID","store_and_fwd_flag","PULocationID","DOLocationID","payment_type",
                   "fare_amount","extra","mta_tax","tip_amount","tolls_amount","total_amount","w", "d"]

# Acceso a los datos particionados en el sistema de archivos
nyc_ds = ds.dataset('Parquet/', partitioning=["w", "d"])

# Configuramos el scanner sobre las columnas establecidas
ds_scanner = nyc_ds.scanner(columns=working_columns)

# Materializamos el resultado como una tabla Arrow
# Aquí ocurre la magia: sin copias, sin objetos Python pesados en memoria
nyc_table = ds_scanner.to_table()
Comparativa: El costo de Pandas
Si intentáramos procesar estos datos usando Pandas, tendríamos que convertir la tabla Arrow a un DataFrame. Esto implica copiar los datos y crear objetos Python, lo que rompe la eficiencia del flujo:
# Convertir tabla Arrow en Pandas Dataframe (Copia de datos -> Pérdida de eficiencia)
nyc_df = nyc_table.to_pandas()

# Filtrado en Pandas
filtro = nyc_df[(nyc_df.total_amount > 100) & (nyc_df.w == "w=17")]
res = filtro["d","total_amount", "passenger_count"]("d","total_amount",%20"passenger_count")
res.head(25)
2. Consulta DuckDB sobre Arrow: Cómputo Vectorizado
La verdadera potencia surge al registrar la tabla Arrow en DuckDB. En lugar de mover los datos, DuckDB simplemente "apunta" a los buffers de memoria de Arrow.
DuckDB utiliza un motor de ejecución vectorizado, lo que significa que procesa bloques de datos (vectores) en lugar de filas individuales, optimizando el uso de las instrucciones SIMD del CPU.
# Iniciamos la conexión a DuckDB
con = duckdb.connect()

# Registro Zero-Copy: DuckDB ahora ve la tabla Arrow como si fuera una tabla nativa
con.register("arrow_t", nyc_table)

# Ejecutamos una consulta OLAP compleja directamente sobre la memoria de Arrow
res = con.execute("""
    SELECT w, d, VendorID, tpep_pickup_datetime, tpep_dropoff_datetime,
           passenger_count, trip_distance, total_amount
    FROM arrow_t
    WHERE (total_amount > 100) AND (w LIKE 'w=17')
    LIMIT 10
""").fetch_arrow_table()  # El resultado vuelve a ser una tabla Arrow (Zero-Copy)

# Visualización del resultado
con.from_arrow(res).show()

# Siempre cerrar las conexiones para liberar recursos
con.close()
Resumen de Ventajas
| Concepto | Enfoque Generalista (Pandas/Python) | Enfoque Especializado (Arrow + DuckDB) |
|---|---|---|
| Memoria | Copias múltiples, objetos pesados | Zero-copy, buffers binarios |
| CPU | Procesamiento fila a fila (Iterativo) | Procesamiento Vectorizado (SIMD) |
| I/O | Lectura completa o manual | Proyección vertical y Predicate Pushdown |
| Escalabilidad | Limitada por la RAM del proceso | Altamente eficiente, optimizado para OLAP |