OTF (Open Table Format): Guía Completa de Arquitectura y Prácticas
Un Open Table Format (OTF) es una especificación de almacenamiento y metadatos diseñada para definir cómo se almacenan los archivos de datos dentro del almacenamiento de objetos (Cloud Object Storage / S3 / MinIO), cómo se estructuran y versionan los metadatos, y cómo múltiples motores de consulta leen y escriben registros de forma coherente y transaccional.
Antes de la llegada de los formatos de tabla abiertos, la mayoría de los Data Lakes funcionaban como volcados de archivos en bruto no gestionados (unmanaged file dumps). Tras la adopción de OTF, el Data Lake se comporta como un sistema transaccional (ACID), gobernado y altamente eficiente para consultas SQL sobre almacenamiento de objetos de bajo coste.
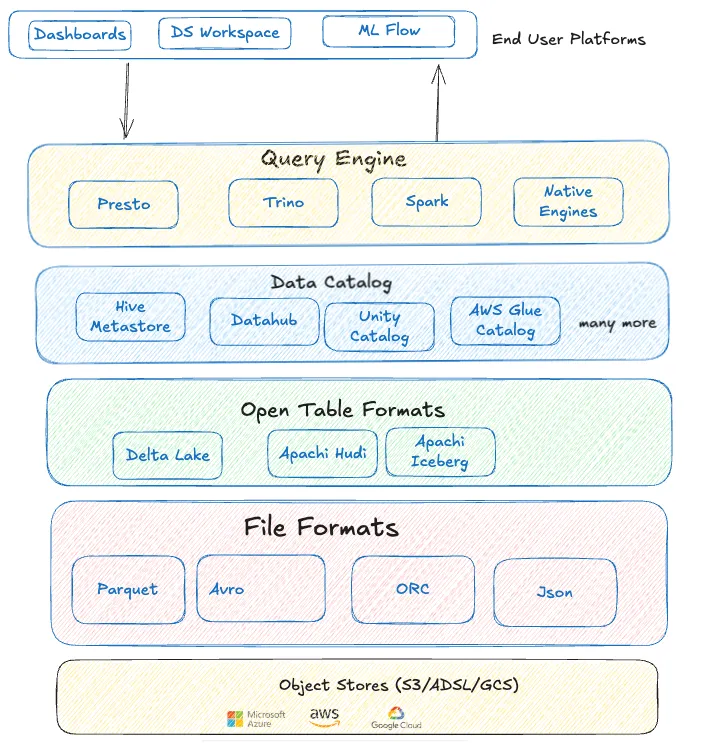
1. Capacidades Fundamentales
Un Data Lake habilitado con OTF permite:
- Control de Esquema y Particionado (DDL): Seguimiento automático de cambios en la estructura de tablas y evoluciones de esquemas sin necesidad de reescribir datos o redefinir tablas.
- Seguimiento de Archivos y Estadísticas de Columnas: Registro preciso de los archivos de datos pertenecientes a la tabla, así como métricas min/max, null counts y estadísticas por columna para optimizar el pruning (poda de archivos).
- Operaciones Transaccionales (DML): Soporte completo para inserciones, actualizaciones y eliminaciones de registros individuales (
INSERT,UPDATE,DELETE,MERGE), garantizando la consistencia ante escrituras concurrentes. - Aislamiento de Transacciones (ACID): Múltiples ejecuciones en paralelo (procesos batch y streaming) pueden leer y escribir simultáneamente sin sufrir corrupción o lecturas sucias.
- Viaje en el Tiempo (Time Travel) y Rollback: Consulta de estados históricos de la tabla mediante copias de seguridad conceptuales basadas en snapshots (capturas instantáneas) y reversión inmediata de commits fallidos.
2. Los Tres Pilares de Funcionamiento de un OTF
Los formatos de tabla abiertos funcionan coordinando tres componentes estructurales clave:
┌─────────────────────────────────────────────────────────┐
│                 3. Protocolo Transaccional               │
│         (Commits atómicos, Aislamiento de Snapshots)     │
└───────────────────────────┬─────────────────────────────┘
                            │
┌───────────────────────────▼─────────────────────────────┐
│                 2. Capa de Metadatos                    │
│   (Manifests / Transaction Logs / Estadísticas / Min-Max)│
└───────────────────────────┬─────────────────────────────┘
                            │
┌───────────────────────────▼─────────────────────────────┐
│                 1. Archivos de Datos                    │
│        (Parquet inmutable en S3 / MinIO / Object Store) │
└─────────────────────────────────────────────────────────┘
- Archivos de Datos (Data Files): Archivos columnares inmutables (como Parquet) que contienen los registros brutos. Las modificaciones no alteran los archivos existentes; en su lugar, se escriben nuevos archivos y se registran en los metadatos.
- Archivos de Metadatos (Metadata Files): Proporcionan la capa de inteligencia del Data Lake.
- Apache Iceberg: Utiliza listas de manifiestos (manifest lists) y manifiestos (manifests) estructurados en árbol.
- Delta Lake: Mantiene un registro de transacciones (transaction log /
_delta_log) estructurado en archivos JSON y checkpoints Parquet. - Apache Hudi: Modela el estado a través de líneas de tiempo (timeline markers) y grupos de archivos asociados a commits y compactaciones.
- Protocolo Transaccional (Transaction Protocol): Protocolo de confirmación (commit) controlled y atómico utilizado por motores como Spark, Flink, Trino, DuckDB o Snowflake. Los escritores publican nuevos archivos e índices aisladamente y actualizan el puntero del último snapshot de forma atómica.
3. Principales Implementaciones de OTF
| Formato | Enfoque Principal | Casos de Uso Destacados |
|---|---|---|
| Apache Iceberg | Estructuras de metadatos profundas, aislamiento estricto de snapshots, independencia de motor. | Entornos multimotor masivos (Trino, Snowflake, Spark, Flink). Usado por Netflix, Apple, Adobe. |
| Delta Lake | Control transaccional sólido, optimización profunda con Apache Spark y ecosistema Databricks. | Cargas de trabajo analíticas en batch/streaming de alto rendimiento. |
| Apache Hudi | Procesamiento incremental rápido y patrones de ingesta con upserts en tiempo real. | Ingesta de datos streaming de baja latencia y compactación eficiente. |
4. Casos de Uso: ¿Cuándo Adoptar un OTF?
- Garantía de Consistencia: Cuando múltiples pipelines (batch y streaming) leen y escriben simultáneamente sobre las mismas tablas.
- Optimización de Rendimiento: Reducción del I/O entre un 50% y un 90% gracias a la poda de metadatos (metadata pruning) y data skipping, logrando consultas entre 3x y 10x más rápidas que las tablas tradicionales de Hive.
- Simplificación Operativa: Eliminación de tareas manuales complejas de reescritura de directorios al renombrar o eliminar columnas.
- Entornos de Producción Críticos: Garantiza lineage claro, trazabilidad de datos y estabilidad para reportes empresariales y modelos de Machine Learning.
5. Caso Práctico de Arquitectura: El Problema de la Concurrencia (Ejemplo Netflix)
En un Data Lake tradicional basado en carpetas de Parquet:
* Un proceso en batch sobrescribe una partición mientras un pipeline en streaming lee la misma carpeta.
* El proceso lector obtiene archivos a medio escribir, genera datos duplicados o registros corruptos, degradando los modelos downstream.
Con un Open Table Format:
* Las modificaciones no sobreescriben datos en el sitio. Se genera un nuevo snapshot de manera aislada.
* Los lectores quedan fijados (pinned) al snapshot previo válido hasta que la transacción se confirma de forma atómica.
* Si el pipeline de escritura falla, el puntero no cambia y la tabla permanece limpia y consistente.
6. Errores Comunes en la Adopción de OTF
- Asumir que OTF arregla un mal modelo de datos: No reemplaza un buen diseño de esquemas, estrategias de particionado adecuadas y manejo de sesgo (skew).
- Uso de configuraciones por defecto: Olvidar ajustar tamaños de archivo, shuffle partitions o intervalos de compactación reduce los beneficios de rendimiento.
- Ignorar el crecimiento de metadatos: Si los snapshots y archivos de registro crecen indefinidamente, el tiempo de planificación de consultas (query planning) empeora. Se requiere mantenimiento periódico (expiración de snapshots,
VACUUM). - Mezclar motores sin planificar semánticas de escritura: Spark, Flink y Trino gestionan la concurrencia de forma distinta; requiere validar el manejo de conflictos.
- Omitir la compactación (Compaction): La ingesta de datos pequeños genera el problema de los "muchos archivos pequeños" (small files problem); la compactación constante es imprescindible.
- Considerarlo un sistema "Plug-and-Play": Requiere gobernanza, monitoreo y alineación con las herramientas de orquestación.
- Asumir que todos los OTF se comportan igual: Es necesario seleccionar la herramienta adecuada según el patrón de carga (batch vs. streaming vs. consultas ad-hoc).
7. Recursos Adicionales y Laboratorios
Guías e Información
- Evolución Histórica de OTF
- OTF + MinIO: Understanding the Lakehouse Architecture
- Architect's Guide to Open Table Formats and Object Storage
Laboratorios Relacionados
Lab DuckDB S3 MinIO
Serie Python Labs