Data Lakes
Introducción
El concepto de Data Lakehouse fue introducido inicialmente por el equipo de Databricks y popularizado posteriormente por Bill Inmon en su libro Building the Data Lakehouse. Hoy en día la idea ha sido ampliamente adoptada por los principales actores en la gestión de datos ya que la arquitectura combina la escalabilidad y la rentabilidad con la infraestructura analítica asociada tradicionalmente a los Data Warehouse. Por ende, es la respuesta arquitectónica a la tensión entre la flexibilidad de los Data Lakes y el rendimiento y gobernanza de los Data Warehouses. En esencia, el paradigma del Lakehouse consiste en llevar el warehouse al lake, y no al revés. Este enfoque híbrido permite leer, procesar y comprender los datos de forma más eficiente, al tiempo que se aprovechan las soluciones de almacenamiento de bajo coste
Cloud Storage (Almacenamiento en la nube)
El almacenamiento en la nube utiliza recursos remotos para mantener, gestionar y proporcionar acceso a los datos. Cuando los usuarios necesitan guardar, acceder o modificar datos, deben conectarse al recurso remoto a través de una red (normalmente Internet). Dado que los costes de estos recursos se distribuyen entre todos los usuarios, los recursos pueden ser más baratos, lo que permite a los usuarios acceder a un almacenamiento a una escala o nivel de rendimiento que de otro modo no podrían permitirse
Almacenamiento de objetos
El almacenamiento de objetos gestiona los datos como unidades discretas denominadas objetos. Cada objeto incluye los datos en sí, metadatos y un identificador único. A diferencia del almacenamiento de archivos y bloques, el almacenamiento de objetos no utiliza una estructura jerárquica. En su lugar, utiliza un espacio de nombres plano, lo que simplifica el escalado y la distribución
Este tipo de almacenamiento es ideal para datos no estructurados, como archivos multimedia, copias de seguridad, registros y archivos. Admite una alta durabilidad y disponibilidad al distribuir los objetos en varias ubicaciones físicas. Se accede al almacenamiento de objetos a través de API basadas en HTTP, como la API S3, lo que lo hace muy adecuado para aplicaciones a escala web y arquitecturas nativas de la nube
Almacenamiento de archivos
El almacenamiento de archivos organiza los datos en una jerarquía tradicional de archivos y directorios. Permite a los usuarios y a las aplicaciones interactuar con los datos de la misma manera que lo harían en un sistema de archivos local. Esto lo hace útil para el acceso compartido a archivos en entornos como sistemas de gestión de contenidos, entornos de desarrollo y directorios de inicio de usuarios
Amazon Simple Storage Service (S3)
Es un servicio de almacenamiento altamente escalable basado en tecnología de almacenamiento de objetos que ofrece las siguientes características clave:
- Buckets: los datos se almacenan en buckets. Cada bucket puede almacenar una cantidad ilimitada de datos no estructurados
- Escalabilidad: sin límite de almacenamiento. Los objetos individuales pueden tener un tamaño de hasta 5 TB
- Estructura de datos flexible: cada objeto se identifica mediante una clave única y se pueden utilizar metadatos para organizar los datos de forma flexible
- Descarga de datos: compartición de datos con cualquier persona dentro o fuera de la organización
- Permisos: permisos a nivel de bucket u objeto para garantizar que solo los usuarios autorizados puedan acceder a los datos
- API de S3: disponible como interfaces REST y SOAP, se ha convertido en un estándar del sector y está integrada con un gran número de herramientas existentes
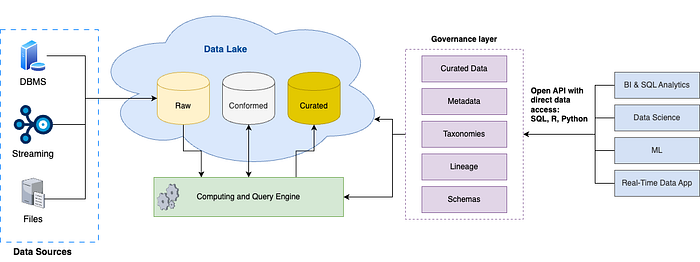
🏗️ Los Tres Pilares del Lakehouse
Para comprender qué es un Lakehouse, debemos analizarlo como una pila de tres capas desacopladas:
1. Almacenamiento Abierto (La parte "Lake")
En lugar de formatos propietarios, el Lakehouse se apoya en formatos columnares abiertos.
- El Estándar: Apache Parquet es la piedra angular.
- Evidencia Técnica: El almacenamiento de datos en Parquet sobre S3 permite una escalabilidad masiva sin depender de un proveedor específico.
- Infraestructura: El almacenamiento de objetos (Amazon S3, Azure Blob Storage, Google Cloud Storage) permite gestionar los datos como unidades discretas con un espacio de nombres plano, ideal para datos no estructurados y escalabilidad web.
2. Formatos de Tabla y Catálogos (La parte "House")
Esta es la capa de abstracción crítica que proporciona transacciones ACID, time travel y evolución de esquemas sobre archivos brutos.
- Los Contendientes: Implementaciones OTF (ver Open Table Format: Guía Completa de Arquitectura y Prácticas) como Apache Iceberg, Delta Lake, Apache Hudi.
- La Guerra de Catálogos: La lucha por definir quién gestiona estas capas de metadatos (ej. Apache Polaris frente al legado de Hive Metastore).
- Aplicación Práctica: Podemos tratar estos archivos en la nube como si fueran tablas SQL locales.
3. Cómputo Desacoplado
La pieza final es la capacidad de ejecutar SQL de alto rendimiento directamente sobre la capa de almacenamiento.
- El Cambio: Migración de clusters pesados y siempre encendidos hacia un "Cómputo a Medida" (Right-Sized Compute).
- Herramientas Modernas: Motores como DuckDB y Polars permiten el "Laptop OLAP", donde la analítica compleja ocurre en el proceso.
- La Prueba: La exposición en el artículo DuckDB + Polars: Fast Enough to Feel Illegal muestra que la capa de cómputo puede ser ahora tan rápida como el almacenamiento.
Resumen: Principios Generales del Data Lakehouse
- Aprovechar la infraestructura preexistente: siempre que sea posible, utilizar infraestructura existente y en opciones de almacenamiento de bajo coste como Amazon S3, Azure Blob Storage o Google Cloud Storage. Los datos deben almacenarse en formatos abiertos, como CSV, Parquet y ORC, para garantizar la compatibilidad y la flexibilidad
- Garantizar la coherencia de los datos con transacciones ACID: utilizar tecnologías para mantener la coherencia de los datos mediante transacciones ACID (atomicidad, coherencia, aislamiento y durabilidad) que a menudo se gestionan mediante SQL
- Admitir la aplicación y la evolución de esquemas: el Data Lakehouse debe admitir la aplicación y la evolución de esquemas, el uso de arquitecturas de esquemas de almacenes de datos como los esquemas en estrella y en copo de nieve
- Implementar mecanismos de gobernanza y auditoría: añadir funciones de gobernanza y auditoría incluido un control de acceso basado en roles muy detallado. Garantizar que la manipulación de datos se pueda realizar a través de diversas API (Scala, Java, Python, SQL) para cumplir con normativas como el RGPD y la CCPA
- Desacoplar el almacenamiento de la computación: la arquitectura debe permitir que los recursos de almacenamiento y computación se escalen de forma independiente dando cabida a más usuarios simultáneos y conjuntos de datos más grandes sin degradación del rendimiento
- Proporcionar acceso directo a los datos: ofrecer acceso directo a datos sin procesar, seleccionados y agregados para herramientas de inteligencia empresarial (BI). Esto reduce la obsolescencia de los datos, mejora su frescura, reduce la latencia y minimiza los costes de mantener copias separadas de los datos
- Admite API no SQL para el procesamiento de datos: incluye APIs declarativas eficientes y no SQL como las API de tipo DataFrame para permitir a los científicos de datos acceder directamente y procesar grandes volúmenes de datos, en particular para experimentos de aprendizaje automático que utilizan bibliotecas R y Python
- Adopción de formatos de datos abiertos y API: compatibilidad con formatos de datos abiertos y API que permiten el acceso directo a los datos sin depender de motores propietarios, lo que evita la dependencia de un proveedor y garantiza la flexibilidad a largo plazo
- Habilitación de la transmisión de datos y el análisis en línea: elimina la necesidad de sistemas separados para gestionar aplicaciones de datos en tiempo real
El concepto de Data Lakehouse parece más un esfuerzo pragmático por codificar el status quo existente que una arquitectura respaldada por un análisis coherente del problema. Dado que no se trata de un concepto innovador, la barrera para su adopción es baja y casi todos los proveedores afirman implementarlo. Aunque este concepto ha ganado un gran impulso, tiene ciertas limitaciones que pueden obstaculizar su eficacia:
- Enfoque centrado en la tecnología: el enfoque del Data Lakehouse se centra principalmente en soluciones tecnológicas, pasando por alto a menudo la importancia de las personas y los procesos en la gestión de datos. Las plataformas de datos eficaces requieren un enfoque holístico que integre la tecnología con las prácticas y la cultura de la organización
- Atención limitada a los silos de datos y la alineación empresarial: aunque el Data Lakehouse hace hincapié en la capacidad de descubrimiento de datos, tiende a descuidar los retos que plantean la eliminación de los silos de datos y la alineación de los activos de datos con los objetivos empresariales. También presta una atención insuficiente al ciclo de vida de los datos, los SLA (acuerdos de nivel de servicio) y los SLO (objetivos de nivel de servicio)
- Gobernanza centralizada frente a agilidad: la gobernanza centralizada y la aplicación de esquemas inherentes al Data Lakehouse pueden obstaculizar la agilidad de la organización. La rápida adaptación es fundamental a medida que las empresas evolucionan, y las estructuras de gobernanza rígidas pueden convertirse en un cuello de botella
- Abordaje inadecuado de los desafíos de la integración de datos: aunque el Data Lakehouse proporciona las capacidades técnicas para la transformación de datos a gran escala, no aborda completamente los desafíos críticos de la integración de datos, como la gestión de la complejidad de los datos, los metadatos y las reglas de mapeo de contexto. Estos son componentes esenciales para crear una plataforma de datos verdaderamente integrada y procesable
Laboratorios relacionados
Labs S3 Data Lakehouse